
През октомври 2023 Google DeepMind* представи технология, която промени начина, по който гледаме на съдържанието, създадено с изкуствен интелект. SynthID е система за вграждане на невидими цифрови водни знаци директно в AI-генериран текст, изображения, аудио и видео. Към май 2025 над 10 милиарда единици съдържание вече носят този невидим идентификатор.
* Google DeepMind е AI изследователското подразделение на Google/Alphabet. През април 2023 Google обедини двата си AI екипа – Google Brain и DeepMind – в една структура, наречена именно Google DeepMind.
Съдържание
Какво е SynthID
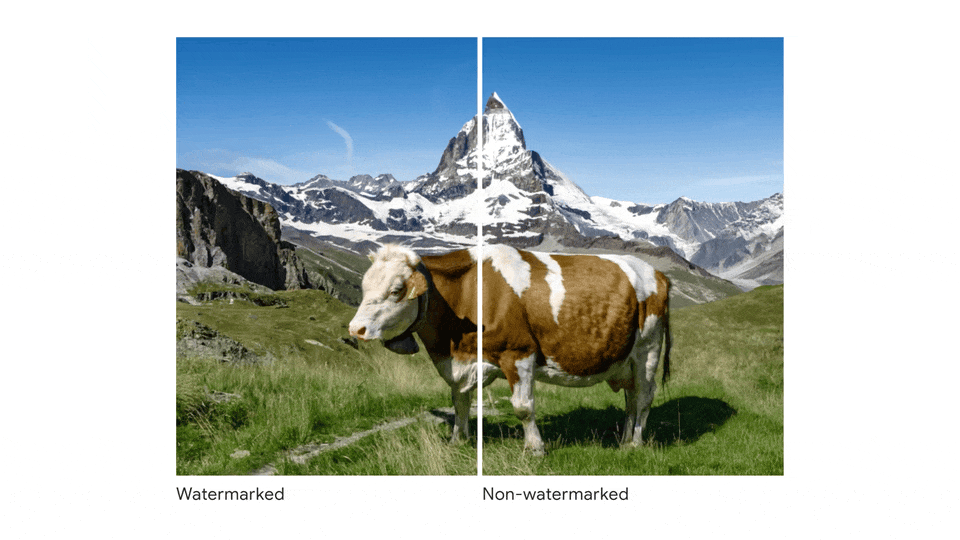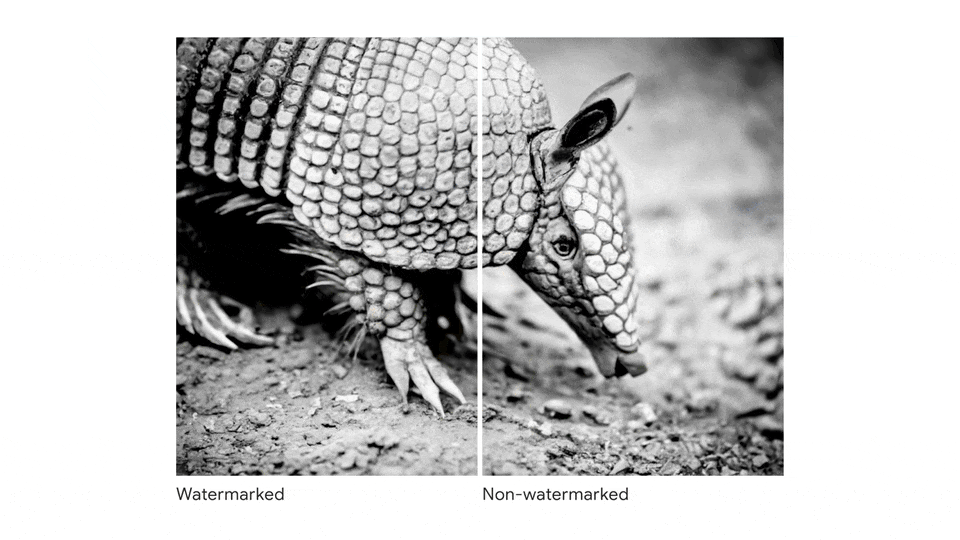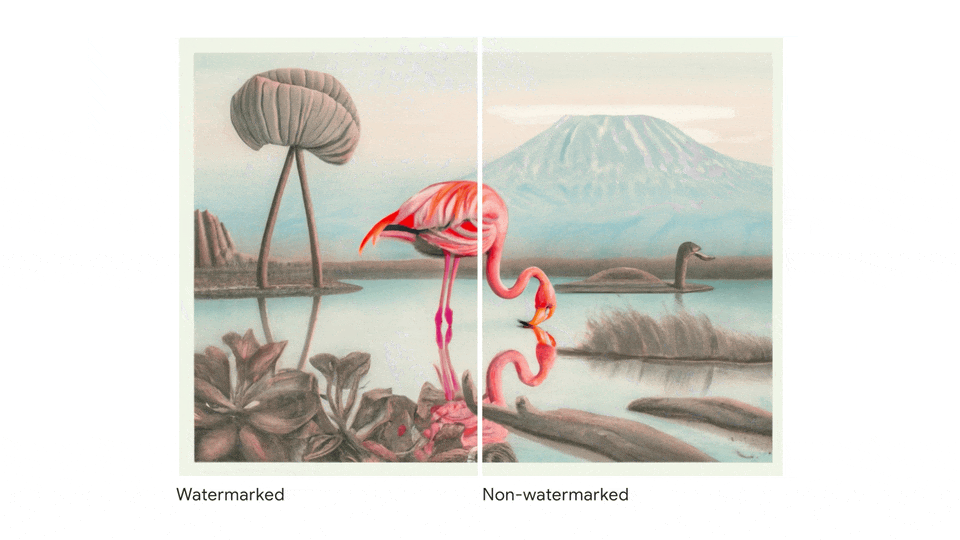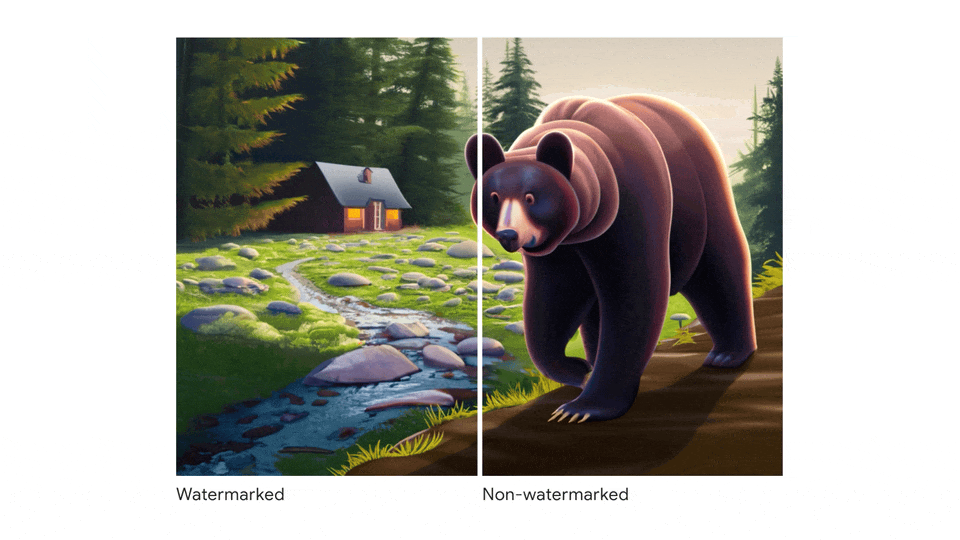
SynthID представлява набор от технологии за маркиране и детектиране на съдържание, произведено от AI модели. Google DeepMind разработи системата с една основна цел – да направи произхода на цифровото съдържание проследим. За разлика от видимите етикети или метаданни, водният знак е вграден директно в самото съдържание по начин, който не влияе на качеството и остава незабележим за човешкото око.
Технологията вече е интегрирана в продуктите на Google. Gemini използва SynthID за текст, Imagen за изображения, Lyria за аудио и Veo за видео. Всяко съдържание, създадено чрез тези модели, автоматично получава водния знак.
Хронология на развитието
SynthID не се появява изведнъж като завършен продукт. Google DeepMind развива технологията поетапно, разширявайки обхвата към нови типове съдържание.
През август 2023 излиза първият прототип за изображения, интегриран в модела Imagen. Това е отговор на нарастващата нужда от прозрачност при визуалните синтетични медии. През май 2024 технологията се разширява към текст чрез Gemini и към видео чрез Veo. Октомври 2024 носи важна стъпка – SynthID Text става open source и достъпен през Hugging Face Transformers. През май 2025 Google представя унифицирания SynthID Detector, който обединява детекцията за всички типове медии на едно място. Ноември 2025 маркира глобалното разпространение заедно с пускането на Gemini 3 Pro, позволявайки на крайните потребители да верифицират съдържание директно през екосистемата на Gemini.
Траекторията показва ясен модел – от затворен вътрешен инструмент към протокол, ориентиран към разработчици.
Как работи технологията
Подходът на SynthID се различава според типа съдържание.
За текст системата работи по време на самия процес на генериране. Когато езиков модел създава текст, той избира всяка следваща дума въз основа на вероятностни оценки. SynthID модифицира тези оценки по контролиран псевдослучаен начин. Резултатът е статистически модел в текста, невидим за читателя, но разпознаваем от специализиран детектор. Важното е, че тези промени не засягат смисъла, качеството или креативността на генерирания текст.
За изображения и видео SynthID използва две невронни мрежи. Първата модифицира цветовите стойности на отделни пиксели толкова минимално, че промяната остава незабележима за човешкото око. Втората мрежа може да открие тези промени дори след типични манипулации като изрязване, компресия, филтриране или правене на скрийншот. При видео всеки кадър получава индивидуален воден знак.
За аудио системата конвертира звуковата вълна в спектрограма – визуално представяне на честотния спектър. Водният знак се вгражда в спектрограмата и след това аудиото се реконструира. Знакът остава нечуваем, но устойчив на стандартна обработка като MP3 компресия.
Техническа архитектура
SynthID се различава фундаментално от традиционния watermarking. Вместо да добавя отделими метаданни, технологията интегрира идентификационни маркери на ниво генериране. Подходът използва принципи на стеганографията – практиката за скриване на информация в други данни. За разлика от C2PA стандарта, който работи с metadata, SynthID оперира директно на model и pixel ниво.
Архитектура за изображения
Системата използва два deep learning модела, обучени съвместно върху разнообразен набор от изображения. Първият модел, наричан „embedder“, модифицира пикселните стойности по време на самия процес на генериране. Промените са математически значими за компютър, но невидими за човешкото око. Вторият модел, „detector“, е обучен да разпознава тези специфични модели. Комбинираният модел е оптимизиран за множество цели едновременно – коректно идентифициране на маркирано съдържание и подобряване на незабележимостта чрез визуално изравняване на водния знак с оригиналното съдържание.
Тъй като водният знак е разпределен в цялото изображение на пикселно ниво, той е устойчив на изрязване, ротация, компресия и филтри.
Tournament Sampling за текст
Текстът е най-трудният тип съдържание за маркиране, защото не можеш да „скриеш“ пиксели в обикновен текстов файл. SynthID Text използва статистически метод, наречен Tournament Sampling.
Големите езикови модели генерират текст чрез предсказване на следващия token (дума или символ) в последователност на база вероятност. SynthID се намесва в този prediction layer. Системата използва псевдослучаен модел, базиран на секретен ключ, за да създаде bias в избора на tokens. За човека читател текстът изглежда напълно естествено, но статистическият модел остава откриваем.
Една страница текст може да съдържа стотици модифицирани вероятностни оценки. Техниката работи дори за три изречения, но с увеличаване на дължината на текста нарастват устойчивостта и точността на детекция.
Спектрограмен подход за аудио
За аудио SynthID не просто добавя високочестотен сигнал, който човек не може да чуе и който би се загубил при MP3 компресия. Вместо това водният знак се вгражда във frequency domain на аудио записа, вплетен в самите данни на звуковата вълна. Това гарантира преживяване на lossy компресия (MP3, AAC), добавен шум и промени в скоростта.
Практическо приложение и достъпност
SynthID Text е публично достъпен чрез open source версия, интегрирана в библиотеката Hugging Face Transformers (версия 4.46.0 и по-нови). Разработчиците могат да го използват със собствените си модели без допълнително обучение – достатъчна е конфигурация, подадена към метода .generate().
SynthID Text:
- Hugging Face Transformers (интегрирана имплементация):
- GitHub (референтна имплементация):
- Официална документация от Google:
Конфигурацията изисква два основни параметъра. Параметърът keys съдържа списък от уникални случайни числа, които определят начина на вграждане на водния знак. Тези ключове трябва да се пазят поверителни, защото разкриването им би позволило имитация на водния знак. Параметърът ngram_len балансира между устойчивост и откриваемост. По-високи стойности правят водния знак по-лесен за откриване, но по-уязвим към промени. Препоръчителната стойност е 5.
През май 2025 Google стартира SynthID Detector – портал за верификация, където журналисти, медийни професионалисти и изследователи могат да качват съдържание и да проверяват за наличие на водни знаци. Порталът показва не само дали съдържанието е маркирано, но и кои конкретни части носят водния знак.
SynthID Detector все още не е публично достъпен (Към януари 2026 г.). Има два начина за проверка:
- Чрез Gemini (достъпно за всички):
- Отиди на https://gemini.google.com
- Качи изображение или видео
- Питай дали е създадено с Google AI
- Или напиши
@synthidза стартиране на верификацията
- SynthID Detector Portal (ограничен достъп):
- Все още е във фаза на тестване с журналисти и медийни професионалисти
- Има waitlist форма: https://docs.google.com/forms/d/1KAkSpRixcGi7pKaPyw5FyahaQqpawmNq65gHgBWgFjg/viewform
Защо се използва SynthID
Основната мотивация зад SynthID е борбата с дезинформацията и неправилното приписване на авторство. С нарастващото качество на AI-генерирано съдържание, способността за разграничаване между човешко и машинно произведен материал става все по-трудна.
Изследване от 2023 показва, че участниците могат да разграничат AI текст от човешки с точност само 50-52 процента – практически случаен резултат. Броят на deepfake видеа онлайн е нараснал с 550 процента между 2019 и 2023 година. Тези данни илюстрират защо технологии като SynthID стават необходимост.
Google не представя SynthID като инструмент за спиране на мотивирани злоупотреби. Компанията признава, че системата може да бъде заобиколена чрез цялостно преписване или превод на друг език. Целта е по-скоро да се затрудни масовата злоупотреба и да се създаде база за изграждане на доверие в цифровото пространство.
Ограничения на технологията
SynthID не е решение за всички ситуации. При текст водният знак е по-малко ефективен при фактически отговори, където изборът на думи е силно ограничен. Ако AI моделът отговаря на въпроси като столицата на определена държава, възможностите за модификация на вероятностите са минимални без да се засегне точността.
Преводът на друг език значително намалява откриваемостта. Същото важи и за цялостно преработване на текста. Леки редакции и парафразиране обикновено не премахват водния знак, но интензивна обработка може да го направи неоткриваем.
При изображения и видео агресивни филтри, екстремни промени в контраста или повторно кодиране с различни параметри могат да компрометират водния знак. За аудио промяна на тоналността или темпото влияе върху спектрограмата и намалява точността на детекцията.
Друго ограничение е обхватът.
SynthID маркира само съдържание от моделите на Google.
Текст от ChatGPT, Claude, Mistral или DeepSeek не съдържа този воден знак. Това означава, че детекторът работи само за част от AI-генерираното съдържание в интернет.
Какво правят останалите AI компании?
OpenAI (ChatGPT):
- Има готова технология за текстови водни знаци с 99.9% точност
- Отказа се да я внедри поради:
- 30% от потребителите казват, че ще използват ChatGPT по-малко
- Лесно заобикаляне чрез превод или преформулиране
- Потенциална дискриминация към non-native English speakers
- Вместо това използват C2PA метаданни за изображения (DALL-E 3, Sora)
- Изследват metadata embedding като алтернатива
Anthropic (Claude):
- Подписали са доброволен ангажимент към Белия дом през 2023 за разработване на watermarking
- Watermarking е „в roadmap-а“, но остава във фаза R&D
- Няма публично внедрен воден знак към момента
Meta:
- Също подписали ангажимента от 2023
- Използват собствени системи, различни от SynthID
- Няма публична информация за текстови водни знаци
Партньорства със SynthID:
- NVIDIA използва SynthID за видеа от Cosmos модела
- GetReal Security интегрира SynthID детекция
- Open source версията позволява на всеки да я внедри
Към януари 2026 г. няма индустриален стандарт. Google е единственият, който активно маркира текст. Другите или са се отказали (OpenAI), или все още изследват (Anthropic, Meta).
Научна публикация и мащаб
През октомври 2024 Google публикува детайлно описание на метода в научното списание Nature. Статията документира техническите изисквания, моделите на заплахи и практическите предизвикателства при внедряване на такава система в интернет мащаб.
Мащабът на внедряване е впечатляващ. SynthID е използван за маркиране на над 10 милиарда изображения и видео кадри през услугите на Google. За контекст – AI е генерирал повече изображения досега, отколкото човечеството е създало за стотици години. Броят на новинарските снимки, правени всяка година, остава относително стабилен, докато обемът на генерирано съдържание расте експоненциално.
Регулаторна рамка в ЕС
Европейският съюз въведе задължения за маркиране на AI съдържание чрез AI Act. Член 50 от регулацията изисква доставчиците на генеративни AI системи да гарантират, че изходите им са маркирани в машинночетим формат и откриваеми като изкуствено генерирани или манипулирани.
През декември 2025 Европейската комисия публикува първия проект на Кодекс за практика относно прозрачността на AI-генерирано съдържание. Документът не налага конкретна технология като SynthID, но препоръчва многослоен подход, включващ метаданни, незабележими водни знаци, fingerprinting и системи за логване.
Кодексът предвижда, че условията за ползване на AI услуги трябва изрично да забраняват премахването или модификацията на водни знаци. За open-weight модели се препоръчва вграждане на структурни маркиращи техники директно в теглата по време на обучение.
Пълното прилагане на член 50 влиза в сила през август 2026. Глобите за неспазване могат да достигнат 15 милиона евро или 3 процента от глобалния годишен оборот.
Влияние върху SEO и GEO
Google официално заявява, че не наказва съдържание само защото е създадено с AI. Позицията на компанията е, че важното е дали съдържанието е полезно, точно и ориентирано към потребителите, а не как е произведено.
На практика обаче ситуацията е по-сложна. SynthID дава на Google техническа възможност да идентифицира машинно генериран текст от собствените му модели. Дали и как тази информация влияе на класирането е въпрос на спекулации. Google не потвърждава директна връзка между водни знаци и ранкинг, но самото наличие на такава технология променя динамиката.
Проучвания показват корелация между сайтове, разчитащи предимно на AI съдържание, и спад в класирането след актуализации на алгоритъма. Това не означава автоматично наказание за AI текст, но подчертава важността на човешката намеса – добавяне на експертиза, проверка на фактите, уникална гледна точка.
За GEO (Generative Engine Optimization) – оптимизацията за AI асистенти като ChatGPT Search и Gemini – въпросът е още по-нов. Тези системи често предпочитат съдържание с доказана автентичност и авторитетност. Маркираното AI съдържание може да получи различно третиране в сравнение с немаркираното, макар конкретните механизми да не са публични.
Практическата препоръка остава същата: AI може да служи като помощник при създаването на съдържание, но не като заместител на човешката експертиза. Редактирането, добавянето на оригинални прозрения и проверката на информацията остават критични фактори.
Екосистемата и партньорства
Google не работи изолирано върху SynthID. Компанията създава партньорства за разширяване на екосистемата. NVIDIA използва SynthID за маркиране на видеа от техния Cosmos модел. GetReal Security, платформа за верификация на съдържание, интегрира детектирането на SynthID водни знаци в услугите си.
Open source версията на SynthID Text позволява на всеки разработчик да вгради технологията в собствени модели. Това е стъпка към създаване на индустриален стандарт, макар други големи играчи като OpenAI и Meta да продължават да използват различни подходи.
OpenAI дори отмени плановете си за текстови водни знаци след вътрешно проучване, показващо че 30 процента от потребителите биха използвали услугата по-малко при въвеждане на маркиране. Това илюстрира напрежението между техническата възможност и пазарното приемане.
Какво означава това за създателите на съдържание
Ако използвате Gemini API за генериране на текст, всеки изход вече носи SynthID воден знак. Това е автоматично и не изисква действие от ваша страна. Други популярни модели като GPT-4, Claude или Mistral не вграждат такива знаци.
За онези, които искат да премахнат водния знак, обработката през синонимизатор или спинер технически може да заличи статистическия модел. Това обаче не гарантира качество на крайния текст и повдига етични въпроси.
По-добрият подход е да се приеме AI като инструмент в процеса на създаване, а не като източник на готов продукт. Редакцията, фактчекингът и добавянето на собствена експертиза не само подобряват качеството, но и намаляват зависимостта от специфични технологични решения.
Заключение
SynthID представлява амбициозен опит за решаване на реален проблем – липсата на прозрачност при AI-генерирано съдържание. Технологията не е перфектна и не претендира да бъде. Мотивирани злоупотреби могат да я заобиколят. Но за масово производство на съдържание тя вдига летвата.
С регулации като EU AI Act и растящото обществено внимание към автентичността на информацията, технологии като SynthID вероятно ще стават все по-разпространени. За създателите на съдържание въпросът не е дали да използват AI, а как да го правят отговорно – със собствен принос, който прави крайния продукт по-ценен от сумата на автоматизираните му части.
https://deepmind.google/models/synthid
https://www.nature.com/articles/s41586-024-08025-4

